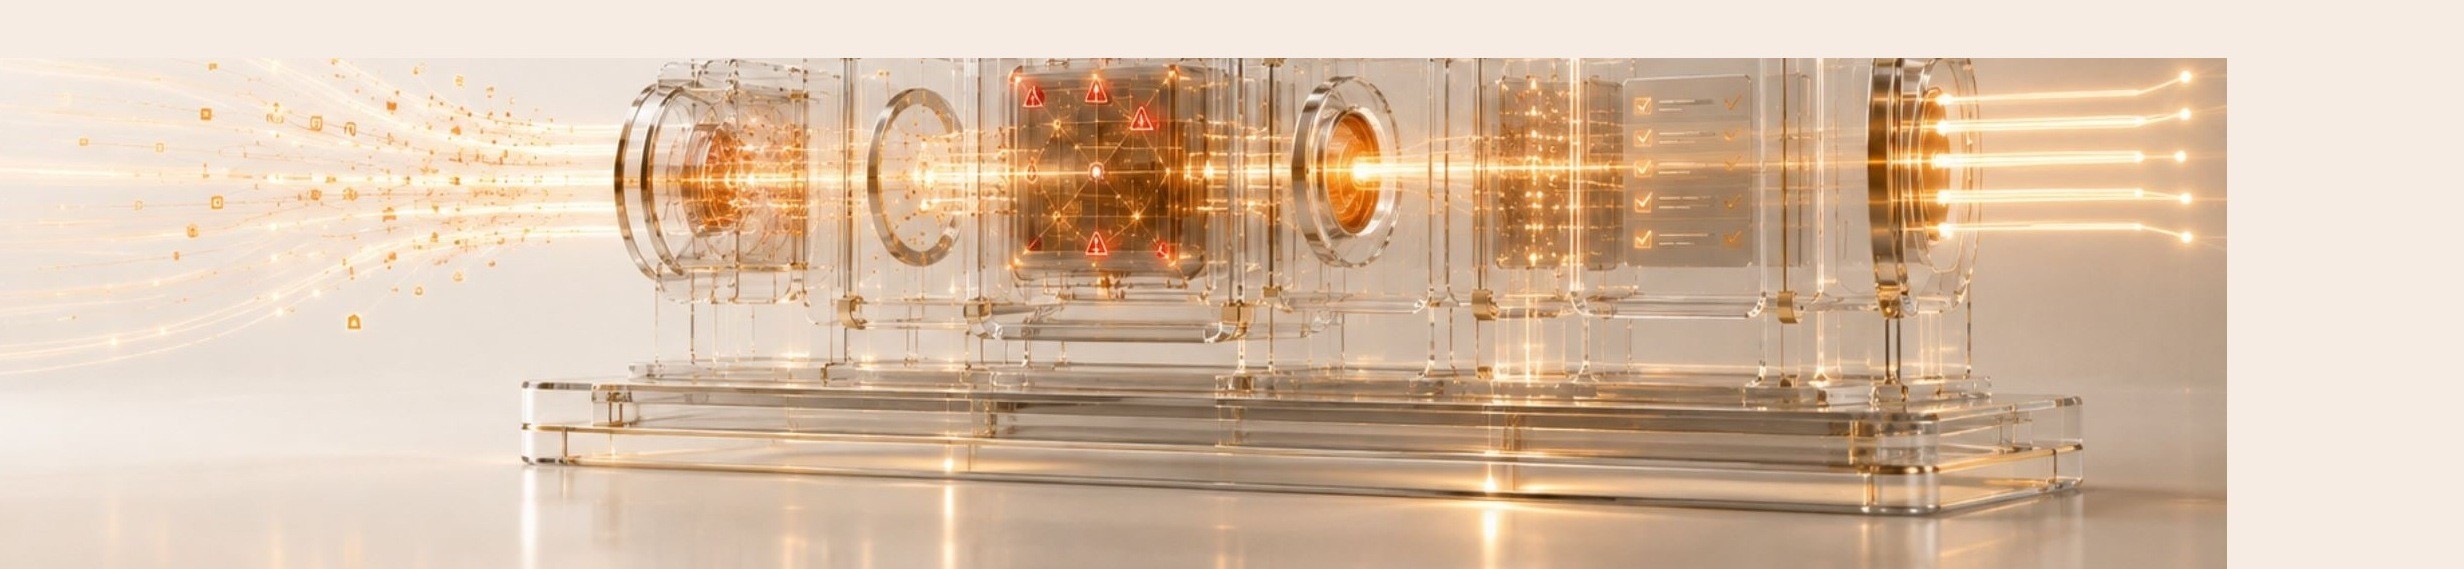
Aucun système ne passe en production sans réussir un test.
N’importe quel concurrent peut promettre que son IA fonctionne. La différence, c’est de vous montrer où elle s’est trompée. Avant que ce que nous construisons touche un enregistrement réel chez vous, c’est noté sur vos propres cas passés - et si la note n’y est pas, ça ne part pas en production.
La ligne la plus utile du document est celle où nous n’étions pas d’accord.
Cabinet de conseil qui peut être partenaire ou acheteur.
Le système l’a qualifié. À la relecture, l’étiquette avait raison : un cas ambigu s’escalade par définition, et la confiance est la mauvaise réponse.
Parfois un désaccord veut dire que le système a tort. Parfois il veut dire que l’étiquette avait tort. Dans les deux cas vous pouvez lire le raisonnement et trancher, ce qu’une démo ne vous donne jamais.
Il tourne sur vos vingt derniers leads avant d’en toucher un en production.
Des cas normaux, bizarres, ambigus et à haut risque, étiquetés par votre équipe, exécutés deux fois pour que le résultat soit démontrablement reproductible.
En dessous, ou sur toute action non sûre non détectée, il ne part pas en production, et nous vous disons exactement pourquoi. Vous recevez la note sous forme de document, quel que soit le résultat.
Quatre étapes, et une seule est une réussite.
Un golden dataset, un Test Report qui note face à lui, une barrière à 85% et une échelle d’autonomie que le système gravit un barreau à la fois. Chaque étape ci-dessous est l’une de ces quatre, dans l’ordre où elles arrivent.
Le golden dataset
Une vingtaine de cas tirés de votre propre historique, choisis et étiquetés par vous - pas par nous. L’étiquetage compte : si nous choisissions les réponses, le test mesurerait notre opinion sur notre propre travail.
normaux
Les cas qui ressemblent à ceux que vous voyez chaque semaine. Si le système ne les gère pas, ce n’est pas un système.
bizarres
Ceux dont votre équipe raconte des histoires. Enregistrements malformés, identités en double, le client qui est aussi partenaire.
ambigus
Ceux sur lesquels deux personnes expérimentées ne seraient pas d’accord. C’est là qu’une mauvaise réponse pleine d’assurance fait le plus de dégâts.
à haut risque
Ceux où se tromper coûte cher ou se voit. Une erreur ici est la seule catégorie d’échec qui n’est jamais acceptable.
Le mélange est délibéré. Un test construit uniquement à partir de cas normaux réussit tout et ne prouve rien ; les tiers bizarre, ambigu et à haut risque sont là où un système gagne la confiance ou révèle qu’il ne devrait pas encore l’avoir.
Le Test Report
Le document qui note le système face à ces cas. Il est écrit pour que vous le lisiez, pas pour que nous le présentions.
Chaque cas reçoit un verdict et le raisonnement qui va avec. Là où le système n’était pas d’accord avec votre étiquette, le rapport le dit et montre son raisonnement, parce qu’un désaccord que vous pouvez lire est la page la plus utile du document - parfois cela veut dire que le système a tort, parfois que l’étiquette avait tort.
Chaque décision porte l’étiquette RULES, AI ou HUMAN, les trois mêmes libellés que ceux de l’Operating Map. Un système surtout fait de règles n’est pas un système inférieur - il est moins cher et plus prévisible, et prétendre le contraire est la façon dont l’IA finit là où elle n’a rien à faire.
- Noter et router un enregistrement entrant
- Supprimer de l’envoi un enregistrement lié à une opportunité ouverte
- Rédiger une première prise de contact et la garder pour approbation
- Écrire dans les trois champs nommés dans le périmètre
- Envoyer quoi que ce soit à un contact d’un compte client
- Envoyer sur un canal où une erreur est publique
- Supprimer ou fusionner un enregistrement, jamais
- Agir sur un cas ambigu : ceux-là s’escaladent par définition
Cette liste est signée avant la mise en production. Déplacer un élément de la colonne de droite vers la gauche est une modification du système, donc un nouveau Test Report, pas un réglage que quelqu’un bascule.
Le journal des preuves
La promesse n’est pas de réussir le test une fois. La promesse est qu’il continue de le réussir.
Une fois qu’un système est en production, chaque décision qu’il prend est consignée avec ses entrées et son raisonnement. Ouvrez une ligne et vous lisez ce à quoi ressemble vraiment un audit six semaines plus tard.
09:14:07Demande de démo entrante notée et routée vers l’AE nomméRULES
09:14:31Identité en double résolue entre deux domaines e-mailAI
11:02:55Cabinet de conseil escaladé, non qualifiéHUMAN
16:41:20Séquence à froid supprimée face à une opportunité ouverteRULES
C’est la réponse à la question que personne ne pose avant que quelque chose tourne mal : pourquoi a-t-il fait ça. Un système incapable d’y répondre n’est pas un système que nous exploiterons.
L’échelle d’autonomie
Un système n’arrive pas avec la permission. Il gagne chaque barreau en réussissant, et la liberté se resserre automatiquement dès que les chiffres baissent.
- 01Observation
Le système tourne sur des données en production et n’entreprend aucune action. Chaque décision qu’il aurait prise est consignée à côté de ce qui s’est réellement passé, pour que vous puissiez lire l’écart avant d’en reprendre quoi que ce soit.
- 02Approbation
Le système propose ; une personne clique. La proposition porte son raisonnement, donc approuver relève du jugement et non du tampon automatique - et les désaccords sont les données qui le font passer au barreau suivant.
- 03Conditionnel
Le système agit seul à l’intérieur d’une limite écrite et escalade tout ce qui en sort. Cette limite est la liste de ce qu’il PEUT et NE PEUT PAS faire, et c’est un document que vous signez, pas un réglage que nous ajustons.
Un seul interrupteur, à chaque barreau, et il est à vous.
Un arrêt d’urgence qui exige un ticket de support n’est pas un arrêt d’urgence. Chaque système que nous exploitons a une commande unique qui l’arrête, accessible sans passer par nous, et elle fonctionne pareil que le système soit au barreau un ou au barreau trois.
Ce que nous pouvons vous montrer aujourd’hui
Aucun Test Report client n’est publié sur ce site, et cette page ne contient aucun exemple client anonymisé qui prétendrait en être un. VANDFORT est un cabinet jeune ; inventer une étude de cas est exactement la faute qui a rendu la version précédente de ce site peu fiable, et nous ne la répéterons pas pour remplir une section.
Ce que nous pouvons montrer, c’est la méthode, et notre propre travail sous cette méthode. Le rapport d’exemple est exécuté sur les systèmes de VANDFORT et la page le dit elle-même.
Le test ne veut dire quelque chose que sur vos données
C’est pourquoi tout commence par l’audit. Trois semaines, et à la fin vous savez quel système construire et ce qu’il devra réussir avant de tourner.